레이블이 MSSQL인 게시물을 표시합니다. 모든 게시물 표시

2020년 3월 17일 화요일

MSSQL - When do select into query, insert fails, but the table is created. why!?


다음은 select into 쿼리이고 #tmp라는 테이블에 'A'를 넣기 위함이다.
하지만 bigint로 convert가 되지 않아서 데이터는 들어가지 않는데 #tmp 테이블은 생성되었다.

테스트해보자.


SELECT CONVERT(BIGINT, 'A') col1 INTO #tmp 를 수행하면 분명 convert error가 발생한다. 그리고 바로 이어서 #tmp를 조회해보면 테이블이 생성되었음을 확인할 수 있다.


그럼 혹시 그럼 혹시 convertable variable와 unconvertable variable를 union all로 묶으면 한개라도 들어갈까?


위와 동일한 결과를 얻을 수 있었고 임시 테이블만 생성이 되는 것을 확인할 수 있다.

- 확인 결과(추가)
auto commit mode에서는 select ... into 쿼리는 2개의 트랜잭션으로 이루어져있는데 첫번째는 테이블을 생성하고 두번째는 데이터를 로드한다. 따라서 후속 삽입이 실패하더라도 테이블이 생성된 것은 commit이 된다.

sql server 과거 버전에서는 2개의 작업이 단일 트랜잭션이었고 그 결과 시스템 테이블의 locking&blocking이 유명했다고 한다.

2019년 9월 30일 월요일

Polybase를 활용한 ETL(mssql -> hadoop) 라이브러리 개발

Polybase를 활용한 ETL(mssql -> hadoop) 라이브러리 개발

ssis, sqoop 등 etl 툴이 많지만 db to db가 아닌 mssql에서 hadoop으로 데이터를 내린다면 polybase를 활용하여 쉽게 해결할 수 있다.

구조(준비물)은 다음과 같다.

1. EtlSqlOperator.java
- Connect mssql, Read sql query file, Run sql, Delete/Move hdfs path
2. EtlSqlOperator.sh
- Run shell script
3. DelHdfsPath.sh
- Delete path if exists
4. MoveHdfsPath.sh
- Move path if exists
5. sql query file
- CETAS query
6. sqljdbc.jar
- For db connection


사용방법
원하는 경로에 etl 디렉토리(상위)를 만들었고 etl 디렉토리 하위에는 sql, lib 디렉토리가 있다. lib에는 jdbc driver를 넣어놨고 sql 디렉토리에는 실제로 날릴 CETAS 쿼리들이 들어있다. 나머지 쉘 스크립트나 java 파일은 etl 디렉토리에 넣어놨다.

1. EtlSqlOperator.java를 자신의 상황에 맞게 수정해서 컴파일 한다.
2. 쿼리 구문을 작성해서 sql 디렉토리 하위에 넣는다.
3. EtlSqlOperator.sh에 2번에서 작성한 sql 쿼리 파일을 추가해서 실행한다.


소스, 드라이버 등 파일은 깃헙에 올려놓았다.
깃헙 주소 : https://github.com/parksuseong/ETL_Library


파일 설명 부분

EtlSqlOperator.java 

import java.sql.Connection;
import java.io.File;
import java.io.FileReader;
import java.io.FileNotFoundException;
import java.io.IOException;

import java.sql.DriverManager;
import java.sql.SQLException;
import java.sql.Statement;
import java.sql.ResultSet;
import java.text.SimpleDateFormat;
import java.util.Date;
import java.io.BufferedReader;
import java.io.IOException;
import java.io.InputStream;
import java.io.InputStreamReader;

public class EtlSqlOperator {

public static void DelPath(String str){

try {
Runtime runtime = Runtime.getRuntime();
Process process = runtime.exec("path/etl/DelHdfsPath.sh " + str );

InputStream is = process.getInputStream();
InputStreamReader isr = new InputStreamReader(is);

BufferedReader br = new BufferedReader(isr);

String line;
   // this is trick
while((line = br.readLine()) != null) {

System.out.println(line);
}


} catch (IOException e1) {
System.out.println("del error..........");
// TODO Auto-generated catch block
e1.printStackTrace();
}

}


public static void MovePath(String str1, String str2){

try {
Runtime runtime = Runtime.getRuntime();
System.out.println("------------------------------------------------------------");
System.out.println("from " + str2 + " to " + str1);
System.out.println("------------------------------------------------------------");
String tmptmp = "path/etl/MoveHdfsPath.sh " + str1 + " " + str2+"*";
Process process = runtime.exec(tmptmp);

InputStream is = process.getInputStream();
InputStreamReader isr = new InputStreamReader(is);

BufferedReader br = new BufferedReader(isr);

String line;
   // this is trick
while((line = br.readLine()) != null) {

System.out.println(line);

}


} catch (IOException e1) {
System.out.println("move error.........");
// TODO Auto-generated catch block
e1.printStackTrace();
}

}


public static void main (String args []) {

String sql = "";
System.out.println("ETL Start...");
System.out.println("PARAMETER FILE NAME IS " + args[0]);

// sql file read
System.out.println("------------------------ READ SQL FILE ----------------------");
try{
File file = new File(args[0]);
FileReader filereader = new FileReader("path/etl/sql/"+file);
int singleCh = 0;
while((singleCh = filereader.read()) != -1){
sql += (char)singleCh;
}
filereader.close();
}catch (FileNotFoundException e) {
// TODO: handle exception
System.out.println(e);
}catch(IOException e){
System.out.println(e);
}


Connection conn = null;
Statement stmt = null;
ResultSet rs = null;

try {

// connect db
Class.forName("com.microsoft.sqlserver.jdbc.SQLServerDriver");
conn = DriverManager.getConnection("jdbc:sqlserver://xx.xxx.x.xx:1433","userid","password");
stmt = conn.createStatement();


int start_idx = sql.indexOf("LOCATION='/")+10;
int end_idx = sql.indexOf(",",10);
// create destination path
String path_str = sql.substring(start_idx,end_idx-1);
// create temp path
String tmp_path = "/user/BIGDATA/DW/STG"+path_str;
// delete temp path if exists
System.out.println("------------------------------ destination path ------------------------------ \n" + path_str);
System.out.println("------------------------------ tmp path ------------------------------ \n" + tmp_path);
System.out.println("--------------------------------------------------");
DelPath(tmp_path);
// create tmp_sql
String tmp_sql = sql.replace(path_str, tmp_path);
System.out.println("------------------------------ tmp sql ------------------------------\n" + tmp_sql);
// run tmp_sql
System.out.println("------------------------------ tmp_sql run ------------------------------");
int result = stmt.executeUpdate(tmp_sql);
// delete destination path if exists
System.out.println("------------------------------ del func ------------------------------");
DelPath(path_str);
System.out.println("------------------------------ del complete ------------------------------");
//move to destination from temp path
MovePath(path_str,tmp_path);
System.out.println("------------------------------ move succ ------------------------------");
} catch (SQLException e) {
e.printStackTrace();
} catch (ClassNotFoundException e) {
e.printStackTrace();
} finally{
try {
if (rs!=null) rs.close();
if (stmt!=null) stmt.close();
if (conn!=null) conn.close();
} catch (SQLException e) {}
}


}

}


EtlSqlOperator.sh


DelHdfsPath.sh


MoveHdfsPath.sh


SQL_TEST_TABLE (example)


주의할 점은 지우고 쓰는 것을 sync를 맞춰야되서 나름대로의 trick을 넣어뒀다.
// this is trick
그렇지 않으면 쓰는동안 지워버리는 문제가 생길 수 있기 때문이다. 그때의 에러는 해당 경로가 존재하지 않는다고 나올 것이다.

2019년 8월 3일 토요일

How to make MSSQL Audits, Encryption ( Data-Database level)

컬럼을 암호화하면 정렬을 하나 마나이기 때문에 인덱스 설정은 무의미하다.
따라서 정렬되야 하는 컬럼을 암호화하면 성능에 문제가 생길 수 있다. 또한 암호화는 데이터 크기도 증가시키기 때문에 물리적인 공간도 더 많이 사용한다.

데이터 암호화
MSSQL이 제공하는 암호화 방법은 다음과 같다.

방법/암호화 함수/복호화 함수
1. 대칭키 사용 암호화(Encrypt using symmetric key)/EncryptByKey/DecrpytByKey
2. 비대칭키 사용 암호화(Asymmetric key usage encryption)/EncryptByAsymKey/DecrpytByAsymKey
3. 인증서를 사용한 암호화(Encryption with Certificates)/EncrpytByCert/DecrpytByCert
4. HASHBYTES 함수를 사용한 암호화(Encryption using the HASHBYTES function)/HASHBYTES/없음(none)


대칭키로 암호화하려면 우선 암호화에 사용할 대칭 키를 만들어야한다.
암호를 사용해서 대칭키를 보호할 수도 있지만 인증서로 보호되는 대칭키를 만들수도 있다.

-- 대칭키 만들기
USE TEST
GO

CREATE SYMMETRIC KEY SECKEY
WITH ALGORITHM = AES_256
ENCRYPTION BY PASSWORD = 'defensepark11@'
GO


대칭 키를 만든 직후에는 대칭 키가 열려있지만 그렇지 않을 때는 명시적으로 열어야 하며 암호가 필요하다.

-- 대칭키 열기
OPEN SYMMETRIC KEY SECKEY
DECRYPTION BY PASSWORD = 'defensepark11@'
GO


--데이터 암호화 시키기
SELECT COL_1, EncryptByKey(Key_GUID('SECKEY'),COL_1) AS SEC_COL_1
FROM TMP_TBL


-- 테스트 테이블 생성
CREATE TABLE TMP_TBL (
COL_1 VARCHAR(50) NOT NULL,
COL_2 VARCHAR(50) NOT NULL,
COL_3 VARCHAR(50) NOT NULL
)


INSERT INTO TMP_TBL VALUES('호날두','호날두','호날두')
INSERT INTO TMP_TBL VALUES('즐라탄','즐라탄','즐라탄')

INSERT INTO TMP_TBL VALUES('메시','메시','메시')

--데이터 복호화 시키기
SELECT COL_1
, EncryptByKey(Key_GUID('SECKEY'),COL_1) AS ENC_COL1
, CONVERT(VARCHAR(50),DecryptByKey(EncryptByKey(Key_GUID('SECKEY'),COL_1))) COL_1
FROM TMP_TBL


암호화&복호화 결과는 다음과 같다.


HASHBYTES 함수를 사용한 암호화
- 암호화를 위해 키나 인증서가 필요하지 않다.
복호화가 불가능하다. (단방향 암호화)
암호화한 컬럼에 인덱스를 생성해서 성능 효과를 볼 수 있다.
(조회할 때 HASHBYTES로 암호화를 해서 조회하면 되니까...)


--암호화 시키기
SELECT COL_1, HASHBYTES('MD5',COL_1)
FROM TMP_TBL

결과는 다음과 같다.


해쉬바이트로 암호화를 시키면 복호화를 할 수는 없지만 조회할려는 데이터를 해쉬바이트로 암호화해서 이퀄조회로 찾으면 된다. 따라서 이건 인덱스를 만들 수 있다.


데이터베이스 암호화
MSSQL 2008부터는 엔터프라이즈 버전에서 새로운 데이터 암호화 방법을 제공한다.
응용프로그램 레벨에서 안건들이고 데이터를 암호화 할 수 있어서 투명한 데이터 암호화(TDE)라 불린다.

단 컬럼 단위의 암호화가 아닌 데이터베이스 전체를 암호화한다.
데이터베이스 암호화는 암호화 함수를 사용하지 않고 MSSQL이 자동으로 암호화한다.
데이터 페이지를 암호화하고 디스크에 기록하고, 데이터를 디스크에서 메모리로 읽어들일 때 복호화한다.
그리고 암호화된 데이터베이스는 다른 서버에 연결(Attach)하거나 복원(Restore)이 불가능하다.


암호화 설정 단계
1. 마스터키 생성
2. 마스터키로 보호되는 인증서 만들기
3. 인증서로 보호되는 DEK(데이터베이스 암호화 키) 만들기
4. 암호화를 사용하도록 데이터베이스 설정


1, 2번은 master DB에서 수행해야하고 3, 4번은 해당 DB에서 수행해야 한다.


1. 마스터키 생성
USE master
GO
CREATE MASTER KEY
 ENCRYPTION BY PASSWORD = 'defensepark11@'


2. 마스터키로 보호되는 인증서 만들기
인증서는 DB 암호화 키를 보호하는데 사용되고 master db에 만들어야 한다.
CREATE CERTIFICATE TDECertificate
 WITH SUBJECT = 'server level certificate for TDE'


3. 인증서로 보호되는 DEK(데이터베이스 암호화 키) 만들기
암호화하려고 하는 대상 DB에서 만들어야하고 DB 암호화 키를 보호하는데 사용된 인증서를 백업받아야한다고 경고메세지가 표시된다. 암호화된 DB를 백업한 후 나중에 복원할 때 인증서가 꼭 필요하기 때문이다.


USE TESTDB
GO
CREATE DATABASE ENCRYPTION KEY
 WITH ALGORITHM = AES_256
 ENCRYPTION BY SERVER CERTIFICATE TDECertificate
GO
쿼리를 날리면 다음과 같이 뜬다.

경고: 데이터베이스 암호화 키를 암호화하는 데 사용된 인증서가 백업되지 않았습니다. 인증서와 인증서에 연결된 개인 키를 즉시 백업해야 합니다. 인증서를 사용할 수 없게 되거나 다른 서버에서 데이터베이스를 복원하거나 연결해야 할 경우 인증서와 개인 키의 백업본이 있어야 합니다. 그렇지 않으면 데이터베이스를 열 수 없습니다.
WARNING : The certificate used to encrypt the database encryption key was not backed up. You should back up the certificate and the private key associated with it immediately. If the certificate becomes unavailable or you need to restore or connect the database from another server, you must have a backup of the certificate and private key. Otherwise, you can not open the database.


4. 암호화를 사용하도록 데이터베이스 설정
ALTER DATABASE TESTDB
 SET ENCRYPTION ON
GO


인증서 백업과 복원
암호화한 데이터베이스는 백업 파일도 암호화된다. 따라서 복원하려면 암호화 키를 보호하는 인증서가 있어야한다. 인증서가 없으면 데이터베이스를 복원할 수도 없고 데이터베이스를 분리해서 다른 서버에 연결할 수도 없다.


인증서 백업 
BACKUP CERTIFICATE 문을 사용해서 인증서를 백업한다. 이때 개인 키도 같이 백업해야 이후에 인증서를 복원할 수 있다.


BACKUP CERTIFICATE TDECertificate
 TO FILE = 'C:\SQLBACKUP\TDECertificate.cer'
 WITH PRIVATE KEY (FILE = 'C:\SQLBACKUP\TDECertificate.pvk' ,
 ENCRYPTION BY PASSWORD = 'defensepark11@')
GO

백업이 되면 폴더에 가서 확인할 수 있다.


인증서 복원
암호화된 데이터베이스를 복원할 새로운 서버에 백업한 인증서와 개인 키를 복사하고 그 백업 파일로부터 인증서를 만든다. master 데이터베이스에 마스터 키가 없으면 만들어야한다. CREATE MASTER KEY 문을 사용해서 대상 서버에서 마스터 키를 만들고, CREATE CERTIFICATE...FROM 문을 사용해서 복사한 인증서 파일로부터 인증서를 복원한다.


USE master

CREATE MASTER KEY
 ENCRYPTION BY PASSWORD = 'defensepark11@'
GO


CREATE CERTIFICATE TDECertificate
 FROM FILE = 'C:\SQLBACKUP\TDECertificate.cer'
 WITH PRIVATE KEY (FILE = 'C:\SQLBACKUP\TDECertificate.pvk',
 DECRYPTION BY PASSWORD = 'defensepark11@')
GO


데이터베이스 암호화 제거

-- 암호화 OFF
ALTER DATABASE TESTDB
 SET ENCRYPTION OFF
GO

-- 데이터베이스 암호화 키 제거
USE TESTDB
GO

DROP DATABASE ENCRYPTION KEY
GO

-- 인증서 제거
USE master
GO

DROP CERTIFICATE TDECertificate
GO

-- 마스터 키 제거
DROP MASTER KEY
GO

-- 복구모델단순으로 변경
ALTER DATABASE TESTDB
 SET RECOVERY SIMPLE
GO

-- 체크포인트 명령어를 몇번 실행시켜서 로그를 완전히 없앤다. 
CHECKPOINT -- 여러번 수행
GO

-- 복구모델 원래대로 변경
ALTER DATABASE TESTDB
 SET RECOVERY FULL
GO


MSSQL 감사(SQL SERVER Audits)

mssql 2008부터 제공되는 mssql 감사 기능은 트리거나 프로파일러와 같은 기능들의 단점을 극복해주는 가장 적절한 감사 기능이다. sql server 감사를 구성해 서버와 데이터베이스에서 발생하는 모든 동작을 추적하여 그 내역을 기록(감사 로그)할 수 있다. 무엇보다도 테이블이나 뷰에 대한 select와 프로시저에 대한 exec 동작도 감사 대상인 것이 장점이다.
보통 실시간 실행 배치를 만들어서 떠다니는 쿼리를 잡아서 로깅하거나 어플리케이션 단에서 로깅을 하도록 하는데 이건 좋은 것 같다.


-- 감사 만들기
USE master
GO

-- 디폴트로 만들기
CREATE SERVER AUDIT [Audit_test]
 TO FILE (FILEPATH = 'C:\SQLLOG\Audit')
GO


/* 옵션 주기
USE master
GO

CREATE SERVER AUDIT Audit_test
TO FILE ( FILEPATH = 'C:\SQLLOG\Audit',
 MAXSIZE = 512MB,
 MAX_ROLLOVER_FILES = 100,
 RESERVE_DISK_SPACE = OFF
) WITH (
 QUEUE_DELAY = 1000,
 ON_FAILURE = CONTINUE
)
GO
*/
-- 감사 활성화 하기
ALTER SERVER AUDIT Audit_test
 WITH (STATE = ON)
GO


감사 사양(Audit Specifications) 만들기
실제 감사 정보를 남기려면 감사 사양을 만들어야 한다.
감사 사양은 서버 감사 사양과 데이터베이스 감사 사양으로 구분되고 서버 감사 사양은 서버 범위에서 발생하는 동작을, 데이터베이스 감사 사양은 데이터베이스 범위에서 발생하는 동작을 기록한다.


--데이터베이스 감사 사양 만들기
USE TESTDB
CREATE DATABASE AUDIT SPECIFICATION Audit_test_spec
 FOR SERVER AUDIT Audit_test
 ADD (SELECT ON OBJECT::dbo.TMP_TBL BY public)
GO


--감사 사양 활성화
ALTER DATABASE AUDIT SPECIFICATION Audit_test_spec
 FOR SERVER AUDIT Audit_test
 WITH (STATE = ON)
GO


--하나 셀렉트 해주고
SELECT TOP 1 *
FROM TMP_TBL

--기록된 감사 확인
SELECT *
FROM sys.fn_get_audit_file('C:\SQLLOG\Audit\Audit_test*',DEFAULT,DEFAULT);


--감사와 감사 사양 제거
USE TESTDB
GO


-- 감사 사양 비활성화
ALTER DATABASE AUDIT SPECIFICATION Audit_test_spec
 WITH (STATE = OFF)
GO


-- 감사 사양 제거
DROP DATABASE AUDIT SPECIFICATION Audit_test_spec
GO

USE master
GO


-- 서버 감사 비활성화
ALTER SERVER AUDIT Audit_test
 WITH (STATE = OFF)
GO


-- 서버 감사 제거
DROP SERVER AUDIT Audit_test
GO


감사 설정은 서버에 무리가 없다고 하는데 트래픽이 있는 곳에서는 무리가 있을 것으로 보이고.. 그래도 필요한 곳에만 감사를 걸어서 문제 발생 여지를 남기지 말자.


2019년 7월 26일 금요일

How to encode/decode base62 using C# and Create MSSQL CLR Object

개발을 하면서 base10, base26, base36, base62, base64등으로 encoding, decoding을 하는 경우가 있다. 그리고 많은 서비스에서 shorten url을 만들 때는 base62로 처리한다. base64로 처리할 경우 특수문자가 들어가기때문에 숫자+알파벳 조합인 base62를 선호한다.

Base62에서 표현가능한 값
- ABCDEFGHIJKLMNOPQRSTUVWXYZabcdefghijklmnopqrstuvwxyz0123456789

가령 어떤 페이지의 원래 주소는 A이며 이 Url이 너무 길어서 base62로 encoding하여 xxx.li/R04R(Shorten url)로 만들었다. 이때 사용자들에게 접속을 유도한 주소는 xxx.li/R04R이고 사용자가 저 주소를 통해 접속하면 서버에서는 R04R을 Decoding하여 6435131(key)를 알아낸다. 그리고 그 key를 DB에서 조회하여 Full Url인 A라는 주소를 찾아낸 후 사용자를 A 주소로 접속하게 한다.

이번 포스팅에서는 C#으로 숏URL을 만들때 사용할 수 있는 base62 인코딩, 디코딩을 구현하고 더 나아가 CLR Obect로 만들어서 DB에서 인코딩/디코딩을 하는 것을 테스트해본다.

자료 링크 : https://github.com/parksuseong/Base62


using System;
using System.Data;
using System.Data.SqlClient;
using System.Data.SqlTypes;
using Microsoft.SqlServer.Server;

using System.Collections.Generic;
using System.Linq;
using System.Text;

public partial class StoredProcedures
{
    private static char Base62Digit(int d)
    {
        if (d < 10){
            return (char)('0' + d);
        }
        else if (d < 36){
            return (char)('A' + d - 10);
        }
        else if (d < 62){
            return (char)('a' + d - 36);
        }
        else{
            throw new ArgumentException("d");
        }
    }
    public static void EncodeBase62(SqlString n)
    {
        int n2 = int.Parse(n.ToString());
        var res = "";
        while (n2 != 0){
            res = Base62Digit(n2 % 62) + res;
            n2 /= 62;
        }
        SqlDataRecord record = new SqlDataRecord(new SqlMetaData("stringcol", SqlDbType.NVarChar, 128));
        record.SetSqlString(0, res);
        SqlContext.Pipe.Send(record);

    }
    private static int Base62Decode(char c)
    {
        if (c >= 'a' && c <= 'z'){
            return 36 + c - 'a';
        }
        else if (c >= 'A' && c <= 'Z'){
            return 10 + c - 'A';
        }
        else if (c >= '0' && c <= '9'){
            return c - '0';
        }
        else{
            throw new ArgumentException("c");
        }
    }
    public static void DecodeBase62(SqlString s)
    {
        SqlString res = "";
        string s2 = s.ToString();
        res = (s2.Aggregate(0, (current, c) => current * 62 + Base62Decode(c))).ToString();
        SqlDataRecord record = new SqlDataRecord(new SqlMetaData("stringcol", SqlDbType.NVarChar, 128));
        record.SetSqlString(0, res);
        SqlContext.Pipe.Send(record);

    }
}


이렇게 만든 프로그램을 실행하여 DLL을 만들었고 그 DLL을 활용하여 MSSQL CLR Object로 만들어보자.

인코딩용/디코딩용 프로시저를 각각 만들기로 한다.
먼저 ASSEMBLY를 생성하하고 각각의 프로시저에서 위에서 생성한 클래스의 알맞은 메서드들을 호출한다.


--drop proc USP_CLR_DECBASE62
--drop proc USP_CLR_ENCBASE62

-- Drop the assembly
IF EXISTS (SELECT * FROM sys.assemblies WHERE name = 'BASE62_CLR')
BEGIN
DROP ASSEMBLY BASE62_CLR
END
GO

-- Create the assembly
CREATE ASSEMBLY BASE62_CLR
FROM 'D:\mssqlClr\BASE62_CLR.dll'
WITH PERMISSION_SET = UNSAFE;
GO


CREATE PROCEDURE USP_CLR_DECBASE62 @STR NVARCHAR(MAX)
WITH EXECUTE AS CALLER AS EXTERNAL NAME BASE62_CLR.StoredProcedures.DecodeBase62
GO


CREATE PROCEDURE USP_CLR_ENCBASE62 @STR NVARCHAR(MAX)
WITH EXECUTE AS CALLER AS EXTERNAL NAME BASE62_CLR.StoredProcedures.EncodeBase62
GO


실제로 잘 동작하는지 확인해보자.

exec USP_CLR_DECBASE62 'R04R'


 --exec USP_CLR_ENCBASE62 '6435131'


잘 동작하는 것을 확인할 수 있다.


C# 코드, DB 스크립트, DLL 파일 다운로드 주소
https://github.com/parksuseong/Base62


2019년 7월 9일 화요일

SQL Server Min/Max Memory 설정 변경하기

과거 DB서버(서버에 DB만 설치된 단독 DB서버)에서 이따금씩 배치 오류가 난 적이 있다.
서버 메모리가 65GB라면 DB메모리를 약  60GB 정도를 할당한 경우였다.

딱히 원인을 알 수 없었는데 MS 전문가의 도움을 받아 로그분석을 한 결과 특정 시간대에 OS의 메모리 부족 현상에 의해 배치가 중단되었고 원인은 MSSQL에서 호출하는 CLR Object로 밝혀졌다. CLR Object로 인해 OS가 사용할 메모리마저 부족했던 것이다.

즉시 MSSQL의 MIN/MAX MEMORY를 살짝 낮춰주었고 이후에는 재발하는 경우가 없었다.

아래 그림처럼 SSMS에서 서버 속성에 들어가서 변경할 수도 있다.


변환 스크립트는 다음과 같다.

-- 먼저 show advanced option을 1로 설정하면 고급 구성 옵션이 표시된다.
-- RECONFIGURE WITH OVERRIDE 옵션을 사용하면 시스템 재기동을 하지 않고 OVERRIDE가 가능하다.
EXEC SP_CONFIGURE 'SHOW ADVANCED OPTIONS', '1' RECONFIGURE WITH OVERRIDE
GO
-- 구성 확인
EXEC SP_CONFIGURE
GO

-- MIN MEMOERY 48GB로 변경
-- RECONFIGURE WITH OVERRIDE 옵션을 사용하면 시스템 재기동을 하지 않고 OVERRIDE가 가능하다.
EXEC SP_CONFIGURE 'MIN SERVER MEMORY (MB)', 49152
RECONFIGURE WITH OVERRIDE
GO

-- MAX MEMOERY 48GB로 변경
-- RECONFIGURE WITH OVERRIDE 옵션을 사용하면 시스템 재기동을 하지 않고 OVERRIDE가 가능하다.
EXEC SP_CONFIGURE 'MAX SERVER MEMORY (MB)', 49152
RECONFIGURE WITH OVERRIDE
GO

-- 먼저 show advanced option을 0로 설정하면 고급 구성 옵션을 닫는다.
-- RECONFIGURE WITH OVERRIDE 옵션을 사용하면 시스템 재기동을 하지 않고 OVERRIDE가 가능하다.
EXEC SP_CONFIGURE 'SHOW ADVANCED OPTIONS', '0' RECONFIGURE WITH OVERRIDE
GO
-- 구성 확인
EXEC SP_CONFIGURE
GO


아래 사진은 임시로 캡처한 것이며 min/max server memory의 config_value값을 보면 현재 7168MB로 설정되어있다. 실행값 run_value도 동일하다.
이를 SP_CONFIGURE 명령어로 변경이 가능하며 RECONFIGURE WITH OVERRIDE를 통해 DB 재시작없이 바로 적용이 가능하다.


2019년 6월 3일 월요일

Hadoop Data를 Polybase로 CREATE EXTERNAL TABLE할 때 발생할 수 있는 에러 및 해결책

MSSQL에서 Polybase로 Hadoop Data를 끌어올 때 어디서 에러가 나는지 찾기가 너무 힘들어서 골치가 아팠다. 사실 하둡에 데이터를 떨구는 사람과 Polybase로 가져가는 사람이 동일하다면 원천 데이터 타입을 알고있기 때문에 원인을 찾기 쉽겠지만 떨구는 사람과 가져가는 사람이 다르다면 데이터 타입을 모르는 상황에서 에러를 잡는데 한참 걸릴 것이다. 실제로 한참 걸렸다.

가령 다음과 같은 상황이다.
Hadoop에 Parquet Format으로 떨궈진 데이터를 MSSQL에서 CREATE EXTERNAL TABLE 하는 경우에 아래와 같은 에러들이 발생할 수 있다.

1. java.lang.Integer cannot be cast to java.lang.Long


이 경우에는 int로 선언되어야 하는데 bigint로 선언된 경우이다.
따라서 bigint -> int로 바꿔주자.

2. java.lang.Long cannot be cast to java.lang.Integer


이 경우에는 bigint로 선언되어야 하는데 int로 선언된 경우이다.
따라서 int -> bigint로 바꿔주자.

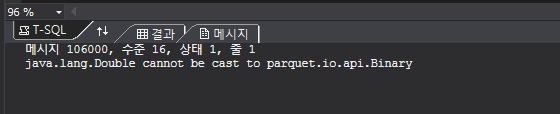
3. java.lang.Double cannot be cast to parquet.io.api.Binary


이 경우에는 float로 선언되어야 하는데 decimal(a,b)로 선언된 경우이다.
따라서 decimal(a,b) -> float로 바꿔주자.

4. java.lang.Double cannot be cast to java.lang.Integer

이 경우에는 float로 선언되어야 하는데 int로 선언된 경우이다.
따라서 int -> float로 바꿔주자.

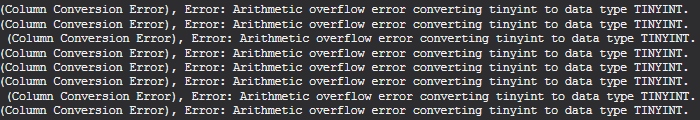
이 외에도 Arithmetic overflow error converting tinyint to data type TINYINT. 식의 에러가 뜰 때에는 int가 맞는 타입인데 tinyint로 선언된 경우이다. 즉 tinyint -> int로 바꿔주자.


사실 윗 부분까지는 근본적인 해결책이 아니다. 일일이 컬럼에 경우의 수를 대입해서 풀지 않기 위해서는 하둡에 떨궈진 데이터의 스키마를 보고 즉시 해결할 수 있다.

제플린에서 df.printSchema()를 통해 dataframe의 스키마를 다음처럼 찍어볼 수 있다.

root
 |-- col1: integer (nullable = true)
 |-- col2: long (nullable = true)
 |-- col3: long (nullable = true)
 |-- col4: double (nullable = true)
 |-- col5: double (nullable = true)
 |-- col6: double (nullable = true)
 |-- col7: integer (nullable = true)
 |-- col8: string (nullable = true)

즉 이런 경우에는 다음처럼 생성하면 된다.

-- integer -> int
-- long -> bigint
-- double-> float
-- string -> varchar

CREATE EXTERNAL TABLE TEST_TBL (
    [col1] int NULL, 
    [col2] bigint NULL, 
    [col3] bigint NULL, 
    [col4] float NULL, 
    [col5] float NULL, 
    [col6] float NULL, 
    [col7] int NULL, 
    [col8] varchar(50) NULL
)
WITH (LOCATION='/user/hello/world/map/seoul/gangnam/201906',
      DATA_SOURCE = HDFS_DS,
      FILE_FORMAT = HDFS_FF_PARQUET,
      REJECT_TYPE = PERCENTAGE,
      REJECT_SAMPLE_VALUE = 10000,
      REJECT_VALUE = 0.1
)

SELECT * FROM TEST_TBL ;

데이터 타입이 잘 맞았다면 조회가 잘 될 것이고 그렇지 않다면 위에서 언급한 에러들이 출력될 것이다.

-
정리를 하면 먼저 하둡에 내린 데이터의 스키마를 알아낸 뒤에 테이블을 만들고 그게 여의치 않다면 에러를 보고 찾아낼 수 있어야 한다. 필자의 경우에는 후자였는데 먼저 해결하고 난 뒤에 근본적인 문제를 찾다보니 결국 스키마를 알아야겠더라.


2019년 6월 2일 일요일

How to make geojson in database(sql server) about korea sido/sigungu/dong polygon

참고 - 대한민국 우편번호별 쉐이프 구해서 Shape 합성 및 DB에 json 형태로 저장하기

포스팅을 조금 더 보강하여 highchart 등의 솔루션으로 실제 web 상에서 구현까지 해보려고 한다. 따라서 위의 포스팅을 참고하면 도움이 될 수 있다. 

- 시작 -
이번 포스팅은 How to make KOREA map data in mssql 이다.
대한민국 우편번호 폴리곤(좌표)으로 시도, 시군구, 읍면동 GEOJSON을 만들고 이를 MSSQL에 저장한다. MSSQL은 Geojson을 저장할 수 있도록 데이터 타입을 제공하며 Polygon Merge, simplification 등의 Geometry 관련 함수들을 제공하기 때문에 Daily batch job을 통해 원하는 결과물로 update가 가능하다.

먼저 다운받은 폴리곤은 시도레벨로 17개이다.


이를 qgis로 열어보면 아래와 같이 나온다.
레이어에서 하나를 선택하고 속성을 들어가보면 인코딩이 UTF-8로 되어있는데 이를 SYSTEM으로 바꿔주자.


이제 17개 시도를 geojson으로 추출할것이다.

먼저 서울특별시를 11.geojson이라는 파일로 추출하였다.

나머지 16개 시도도 똑같이 geojson으로 추출하자.
추출한 총 17개 geojson이다.


11.geojson 파일을 열어보면 다음과 같다.

json 형태로 저장되었으며 Beatify로 보니 features 하위에 BAS_ID(우편번호) 레벨로 나뉘어져있음을 확인할 수 있다.

저번 포스팅에서는 이를 python으로 파싱하여 db에 올리기 쉽게  csv형태로 저장하였다.
이번에도 똑같이 parser를 만들지만 node js로 만들어보자.

geojson_parser.js 파일은 포스팅 하단에 링크를 올려두었다.


저장된 11.csv 이다. 인코딩에 문제가 있어서 ansi로 다시 저장하였다.
총 17개의 csv가 나왔으며 일일이 파싱을 해주었는데도 컴퓨터가 뜨거워졌다..ㅠㅠ


mssql에 올린 결과는 다음과 같다.


총 17개의 테이블이 생성되었고 이를 하나로 만들자.

CREATE TABLE [dbo].[KOREA_POLYGON](
[code] [varchar](50) NOT NULL,
[CTP_KOR_NM] [varchar](50) NOT NULL,
[SIG_KOR_NM] [varchar](50) NOT NULL,
[BAS_ID] [varchar](50) NOT NULL,
[type] [varchar](50) NOT NULL,
[coordinates] GEOMETRY NULL
) ON [PRIMARY]

coordinates 컬럼을 GEOMETRY로 만들었다. varchar(max)에서 "만 빼주면 geometry가 되기 때문이다.

이제 KOREA_POLYGON 이라는 테이블에 데이터를 모은다.

INSERT INTO KOREA_POLYGON
SELECT *
FROM (
SELECT code, CTP_KOR_NM, SIG_KOR_NM, BAS_ID, type, REPLACE(coordinates,'"','') coordinates FROM GEOJSON..[11]
UNION ALL SELECT code, CTP_KOR_NM, SIG_KOR_NM, BAS_ID, type, REPLACE(coordinates,'"','') coordinates FROM GEOJSON..[26]
UNION ALL SELECT code, CTP_KOR_NM, SIG_KOR_NM, BAS_ID, type, REPLACE(coordinates,'"','') coordinates FROM GEOJSON..[27]
UNION ALL SELECT code, CTP_KOR_NM, SIG_KOR_NM, BAS_ID, type, REPLACE(coordinates,'"','') coordinates FROM GEOJSON..[28]
UNION ALL SELECT code, CTP_KOR_NM, SIG_KOR_NM, BAS_ID, type, REPLACE(coordinates,'"','') coordinates FROM GEOJSON..[29]
UNION ALL SELECT code, CTP_KOR_NM, SIG_KOR_NM, BAS_ID, type, REPLACE(coordinates,'"','') coordinates FROM GEOJSON..[30]
UNION ALL SELECT code, CTP_KOR_NM, SIG_KOR_NM, BAS_ID, type, REPLACE(coordinates,'"','') coordinates FROM GEOJSON..[31]
UNION ALL SELECT code, CTP_KOR_NM, SIG_KOR_NM, BAS_ID, type, REPLACE(coordinates,'"','') coordinates FROM GEOJSON..[36]
UNION ALL SELECT code, CTP_KOR_NM, SIG_KOR_NM, BAS_ID, type, REPLACE(coordinates,'"','') coordinates FROM GEOJSON..[41]
UNION ALL SELECT code, CTP_KOR_NM, SIG_KOR_NM, BAS_ID, type, REPLACE(coordinates,'"','') coordinates FROM GEOJSON..[42]
UNION ALL SELECT code, CTP_KOR_NM, SIG_KOR_NM, BAS_ID, type, REPLACE(coordinates,'"','') coordinates FROM GEOJSON..[43]
UNION ALL SELECT code, CTP_KOR_NM, SIG_KOR_NM, BAS_ID, type, REPLACE(coordinates,'"','') coordinates FROM GEOJSON..[44]
UNION ALL SELECT code, CTP_KOR_NM, SIG_KOR_NM, BAS_ID, type, REPLACE(coordinates,'"','') coordinates FROM GEOJSON..[45]
UNION ALL SELECT code, CTP_KOR_NM, SIG_KOR_NM, BAS_ID, type, REPLACE(coordinates,'"','') coordinates FROM GEOJSON..[46]
UNION ALL SELECT code, CTP_KOR_NM, SIG_KOR_NM, BAS_ID, type, REPLACE(coordinates,'"','') coordinates FROM GEOJSON..[47]
UNION ALL SELECT code, CTP_KOR_NM, SIG_KOR_NM, BAS_ID, type, REPLACE(coordinates,'"','') coordinates FROM GEOJSON..[48]
UNION ALL SELECT code, CTP_KOR_NM, SIG_KOR_NM, BAS_ID, type, REPLACE(coordinates,'"','') coordinates FROM GEOJSON..[50]
) A


실제로 데이터가 들어간 모습이다.


한번 간단하게 대한민국 전체 지도를 만들어보자.
SELECT code
   , geometry::UnionAggregate(coordinates.MakeValid().Reduce(100).STBuffer(1000)) AS WKT
FROM KOREA_POLYGON
GROUP BY code

대략 모양이 처음 qgis에서 추출하기 전의 모습과 비슷하다.

현재 우편번호별로 polygon이 저장되어있고 원하는데로 우편번호끼리 합성을 하여 지도를 개편할 수 있다.
이제 이를 화면에 그려보는 작업을 진행할 것이다.
일단 생각으로는 포털에서 제공하는 api를 활용하지 않고 highchart같은 솔루션을 활용하여 그려볼 생각이다.

학부시절 컴퓨터그래픽스(opengl)을 한 것이 작업할 때 검색 키워드를 찾는데 도움이 되었다.
작업 내용은 > 구글 드라이브 < 에 올려놓았다.

2019년 5월 25일 토요일

HOW TO CREATE MSSQL Audit (Server, Database level)

MSSQL 2008부터 제공되는 MSSQL 감사 기능은 트리거나 프로파일러와 같은 기능들의 단점을 극복해주는 가장 적절한 감사 기능이다. SQL SERVER 감사를 구성해 서버와 데이터베이스에서 발생하는 모든 동작을 추적하여 그 내역을 기록(감사 로깅)할 수 있다.
무엇보다도 테이블이나 뷰에 대한 select와 프로시저에 대한 EXEC 동작도 감사할 수 있다는 것이 장점이다.
감사를 사용하지 않는다면 트리거를 사용하거나 실시간 실행 배치를 만들어서 떠다니는 특정 쿼리를 잡아서 로깅하거나 어플리케이션 단에서 로깅을 하도록 해야하는데 감사는 출력 파일을 별도 디스크에 담을 수 있어서 유용할 것 같다.

크게 서버수준(로그인 실패성공, 로그아웃 등)과 데이터베이스 수준에서 감사가 가능하다.
쉽게 설명하면 감사를 만들고 감사스펙을 만들고 둘다 ON 시키면 알아서 로깅한다.


먼저 서버 감사를 만든다.

USE master
GO
-- 서버 감사 만들기
-- 최대사이즈 512mb
-- 파일이 100개되면 롤오버되도록
-- 공간 미리 할당(디폴트가 off)
-- 쿼리딜레이 1초, 감사 실패시 계속
CREATE SERVER AUDIT [Audit_test]
TO FILE ( FILEPATH = 'D:\mssql_audit',
MAXSIZE = 512MB,
MAX_ROLLOVER_FILES = 100,
RESERVE_DISK_SPACE = OFF
) WITH (
QUEUE_DELAY = 1000,
ON_FAILURE = CONTINUE
);

-- 아래 구문처럼 Default로도 생성이 가능하다.
-- CREATE SERVER AUDIT [Audit_test] TO FILE (FILEPATH = 'D:\mssql_audit')


-- 서버 감사 ON
ALTER SERVER AUDIT Audit_test
WITH (STATE = ON)
GO

서버 감사의 STATE를 ON으로 바꿔주면 해당 경로에 감사 파일이 생성된다.

서버 감사 스펙을 생성해보자.
로그인 성공, 실패, 로그아웃 세가지 경우를 잡도록 해본다.
-- 서버 감사 스펙 생성
CREATE SERVER AUDIT SPECIFICATION ServerAuditSpecification
FOR SERVER AUDIT [Audit_test]
ADD (SUCCESSFUL_LOGIN_GROUP), --로그인 성공
ADD (LOGOUT_GROUP), --로그아웃
ADD (FAILED_LOGIN_GROUP) --로그인 실패
GO
-- 서버 감사 스펙 ON
ALTER SERVER AUDIT SPECIFICATION ServerAuditSpecification
FOR SERVER AUDIT Audit_test
WITH (STATE = ON)
GO


다음은 Adventureworks2017 DB에 데이터베이스 수준 감사를 생성한다.
Person.Person에 감사를 적용해보도록 하자.

USE ADVENTUREWORKS2017
GO
CREATE DATABASE AUDIT SPECIFICATION Audit_test_spec
FOR SERVER AUDIT Audit_test
ADD (SELECT ON OBJECT::[Person].[Person] BY public)
GO

-- 방금 생성한 데이터베이스 감사 ON
ALTER DATABASE AUDIT SPECIFICATION Audit_test_spec
FOR SERVER AUDIT Audit_test
WITH (STATE = ON)
GO

이제 실제로 동작하는지 확인해보자.
아래의 쿼리를 수행하고 아까 위에서 생성된 파일을 SELECT 해보도록 하자.
SELECT *
FROM Person.Person
WHERE FirstName LIKE '%JO%'

-- 감사 내용 확인
SELECT *
FROM sys.fn_get_audit_file('D:\mssql_audit\Audit_test*',DEFAULT,DEFAULT)


로그아웃을 하고 로그인을 해보고 다시 수행해보자.

SELECT *
FROM sys.fn_get_audit_file('D:\mssql_audit\Audit_test*',DEFAULT,DEFAULT)


로그인, 로그아웃 기록이 남는 것을 확인할 수 있다.

실제로 적용을 한다면 서버 수준부터 데이터베이스 수준까지 다 잡아야하나 라는 생각이 드는데 실제로 무언가 사고(?)가 난다면 이런 감사를 다 검사하는 것도 귀찮은 일이 될 것 같다.

특수한 환경이 아니라면 적당히 타협해서 데이터베이스 수준의 특정 테이블에 액션을 가하는 정도만 잡아도 충분하지 않을까..
전체를 다 감사하기에는 성능적인 측면에서 서버에 무리를 줄 것이고 모든 기록이 다 남는다는 것 자체가 추후 일을 만드는 것 + 개발 시 아무래도 자유도가 떨어져서 퍼포먼스 측면에서도 비효율 적일 것 같다는 생각이 든다.

2019년 4월 2일 화요일

MSSQL Polybase CETAS 배치 생성할 때 팁 - 약속된 파일을 하나 더 내린다.

시나리오 : 하둡 데이터를 MSSQL로 매일 특정 시간에 가져오는 배치를 짠다고 가정한다.
예를 들어 하둡 경로가 다음처럼 떨궈진다.
/app/hadoop/korea/visit/20190101
/app/hadoop/korea/visit/20190102
/app/hadoop/korea/visit/20190103
/app/hadoop/korea/visit/20190104
....
위와 같은 방식으로 날짜를 바꾸면서 하둡 데이터를 떨구고 있다고 가정한다.

그리고 이후 다른 시스템으로 해당 하둡 데이터를 가져가는 배치가 있다고 생각한다.

가령 SSIS를 활용해서 MSSQL로 하둡 데이터를 가져간다고 가정한다.

보통 MSSQL문법으로 하둡 경로를 알고 있을 때 우리는 다음과 같은 문법으로 외부테이블을 생성할 수 있다.
CREATE EXTERNAL TABLE ~
LOCATION ~
하지만 특정 상황이 발생하여 데이터를 못 떨궜을 경우 해당 경로가 없어서 저 CREATE(일명 CETAS) 문을 실행할 수가 없다.


이때 우리는 배치에서 주기적으로 하둡 경로를 반복적으로 체크하면서 생성된 이후에 데이터를 가져오면 된다.


하둡 명령어 중에 fs -test -e /app/hadoop/korea/visit/20190101 (-s는 file, -d는 디렉토리이면.. 등 여러 옵션이 있다.)를 먼저 날리고 0을 반환하면 경로가 있다는 의미이다.

즉 아래 명령어를 먼저 날려보고

경로가 존재하지 않으면 1을 return 한다.

경로가 존재하면 0을 return 한다.


이걸 활용하면 다음과 같은 방법이 가능하다.
1. 하둡 데이터를 떨굴 때 원하는 것을 다 떨구면 해당 경로에 success라는 크기가 0인 파일을 하나 더 떨구게 한다.
2. 가져가는 배치쪽에서 loop를 만들고 반복문 안에서 데이터를 가져오기 전에 fs -test -s /app/hadoop/korea/visit/20190101/success 를 날린다
3. 리턴값이 0이면 루프를 탈출하고 1이면 10분에 한번씩 저 명령어를 하둡에 찔러본다.
4. 루프를 탈출하면 mssql에서 create external table 문 실행한다.

이런식으로 데이터가 생성될때까지 기다리고 일정 횟수 이상이되면 그냥 skip하도록 배치를 짜면 나름(?) 방어로직이 될 것이다.

2022년 회고

 올해는 블로그 포스팅을 열심히 못했다. 개인적으로 지금까지 경험했던 내용들을 리마인드하자는 마인드로 한해를 보낸 것 같다.  대부분의 시간을 MLOps pipeline 구축하고 대부분을 최적화 하는데 시간을 많이 할애했다. 결국에는 MLops도 데이...