레이블이 hadoop 설치인 게시물을 표시합니다. 모든 게시물 표시

2020년 11월 30일 월요일

Apache Hadoop 3.1.4 HA(High Availability) Install Guide with Cloudera guide

과거에 개인적으로 하둡 2~3 버전을 완전분산 모드로 설치를 해보면서 확실히 크게 달라진 점은 없었다. 당시에는 HA구성을 할 필요가 없었는데 이번에 HA 구성을 해보려고 한다.
하지만 프로덕션 환경에서 설치하기위해서 최적의 구성을 생각했어야했는데 개인적으로 생각한 내용과 클라우데라에서 제안한 아키텍처를 보더라도 크게 차이는 없었다.


출처 : 클라우데라 제안 구성

여기서 상황에 맞게 필요한 것만 구성을 하고 결론은 마스터 3대, 배치서버1대, 데이터노드 N대로 구성하고 다음과 같은 룰을 따르고자 한다.

리소스 매니저는 Yarn을 한번 올려보고.. 실제로 사용은 Mesos로 컨트롤 할 것이다. Mesos의 장점이 하둡 클러스터의 구간을 나눠놓고 1번 메소스, 2번 메소스, 3번 메소스 클러스터로 분리운영이 가능한데 이는 서버가 장애가 날때, 혹은 배치들을 분리했을 때 운영상 장점이 있기 때문이다.

대략적인 구조는 이런식으로 가져간다.


마스터1 : 주키퍼 저널노드 네임노드(HA) ZKFC 리소스매니저(HA) 메소스마스터

마스터2 : 주키퍼 저널노드 네임노드(HA) ZKFC 리소스매니저(HA) 메소스마스터

마스터3 : 주키퍼 저널노드 잡히스토리서버 스파크히스토리서버 메소스마스터

슬레이브서버들 : 데이터노드 메소스슬레이브


사실 yarn을 쓸 일은 거의 없긴한데 일단 sqoop이나 다른 프레임워크들과 etl을 하면서 필요할 일이 있으니 넣어두고 ha를 굳이 안해도되는데 간단하니까 해보자. 왠만하면 최소화로 가져가야 서버를 리부팅할때 올려야할 서비스를 빼먹지 않기 때문에 간소화하는 것을 좋아한다.

설치는 자바설치, /etc/hosts, 인증키 배포 등 기본적으로 세팅해놓아야 할 설정들은 모두 되었다고 가정을 한다.


먼저 마스터 3대에 주키퍼를 설치한다. (3.6.2 설치함.)
zoo_sample.cfg를 복사해서 zoo.cfg를 만들고
dataDir=path
server.1=master1:2888:3888
server.2=master2:2888:3888
server.3=master3:2888:3888
적당한 곳으로 세팅한다.
다 되었으면 주키퍼를 띄운다. (./zkServer.sh start)

다음은 바로 하둡이다.
압축을 풀고 
tar -zxvf hadoop-3.1.4.tar.gz
링크를 걸고
ln -s hadoop-3.1.4 hadoop
필요한 환경세팅을 세팅한다.


기존에는 slaves, masters로 나뉘어져있던 파일이 /etc/workers로 통합이 되었고 여기에 datanode가 올라갈 서버들을 적는다.

각각의 서버는 data01, appData01~04로 구성이 되어있고 하둡은 data01에 두고 log나 data를 쓰는 부분은 appData01로 구성한다. 하둡 같은 경우는 os부분만 레이드1(미러링) 하고 나머지는 솔직히 안해도 된다고 본다. 어차피 3복제이고 하둡을 다시 올리는데 큰 리소스가 안들기 때문이다.

그럼 설정파일을 작성하자.
하둡 설정파일들이 default로라도 되어있으면 좋은데 그냥 깡통이라서 사실 하나씩 쓰기가 너무 괴롭다..

hadoop-env.sh에 몇몇 필요한 경로 세팅을 하고 저장한다.
주석을 풀고 커스터마이징해서 작성하면 된다.
HADOOP_CONF_DIR
HADOOP_HEAPSIZE_MAX
HADOOP_WORKERS
HADOOP_LOG_DIR
HADOOP_PID_DIR
HADOOP_SECURE_PID_DIR


다음은 hdfs-site.xml이다.
<configuration>
        <!-- for NameNode -->
        <property>
                <name>dfs.namenode.name.dir</name>
                <value>/appData01/hadoop/hdfs/name,/appData02/hadoop/hdfs/name,/appData03/hadoop/hdfs/name,/appData04/hadoop/hdfs/name</value>
        </property>

        <!-- for DataNode -->
        <property>
                <name>dfs.datanode.data.dir</name>
                <value>/appData01/hadoop/hdfs/data,/appData02/hadoop/hdfs/data,/appData03/hadoop/hdfs/data,/appData04/hadoop/hdfs/data,/appData05/hadoop/hdfs/data</value>
        </property>

        <!-- HA -->
        <property>
                <name>dfs.nameservices</name>
                <value>hadoop-cluster-bdnode</value>
        </property>
        <property>
                <name>dfs.ha.namenodes.hadoop-cluster-bdnode</name>
                <value>namenode1,namenode2</value>
        </property>
        <property>
                <name>dfs.namenode.rpc-address.hadoop-cluster-bdnode.namenode1</name>
        <value>master1:8020</value>
        </property>
            <property>
                    <name>dfs.namenode.rpc-address.hadoop-cluster-bdnode.namenode2</name>
                        <value>master2:8020</value>
            </property>
        <property>
                <name>dfs.namenode.http-address.hadoop-cluster-bdnode.namenode1</name>
                <value>master1:50070</value>
        </property>
        <property>
                <name>dfs.namenode.http-address.hadoop-cluster-bdnode.namenode2</name>
                <value>master2:50070</value>
        </property>
        <property>
                <name>dfs.namenode.shared.edits.dir</name>
                <value>qjournal://master1:8485;master2:8485;master3:8485/hadoop-cluster-bdnode</value>
        </property>
        <property>
                <name>dfs.client.failover.proxy.provider.hadoop-cluster-bdnode</name>
                <value>org.apache.hadoop.hdfs.server.namenode.ha.ConfiguredFailoverProxyProvider</value>
        </property>
        <property>
                <name>dfs.ha.fencing.methods</name>
                <value>sshfence</value>
        </property>
        <property>
                <name>dfs.ha.fencing.ssh.private-key-files</name>
                <value>/home/scom/.ssh/id_rsa</value>
        </property>
        <property>
                <name>dfs.journalnode.edits.dir</name>
                <value>/appData01/hadoop/hdfs/journalnode</value>
        </property>
        <property>
                <name>dfs.ha.automatic-failover.enabled</name>
                <value>true</value>
        </property>
        <property>
                <name>dfs.blocksize</name>
                <value>268435456</value>
        </property>
        <property>
                <name>dfs.namenode.handler.count</name>
                <value>100</value>
        </property>
        <property>
                <name>dfs.hosts</name>
                <value>/data01/sw/hadoop/etc/hadoop/workers</value>
        </property>
        <property>
                <name>dfs.webhdfs.enabled</name>
                <value>true</value>
        </property>
        <property>
                <name>dfs.namenode.datanode.registration.ip-hostname-check</name>
                <value>false</value>
        </property>

        <property>
                <name>dfs.datanode.du.reserved</name>
                <!-- cluseter variant 90G -->
                <value>96636764160</value>
                <description>Reserved space in bytes per volume. Always leave this much space free for non dfs use.</description>
        </property>
</configuration>


다음은 core-site.xml이다.
<configuration>
        <property>
                <name>fs.defaultFS</name>
                <value>hdfs://hadoop-cluster-bdnode</value>
        </property>
        <property>
                <name>ha.zookeeper.quorum</name>
                <value>master1:2181,master2:2181,master3:2181</value>
        </property>
        <!-- trash -->
        <property>
                <name>fs.trash.interval</name>
                <value>14400</value>
                <description>Number of minutes after which the checkpoint gets deleted. If zero, the trash feature is disabled. </description>
        </property>
        <!-- for HUE-->
        <property>
                <name>hadoop.proxyuser.hue.hosts</name>
                <value>*</value>
        </property>
        <property>
                <name>hadoop.proxyuser.hue.groups</name>
                <value>*</value>
        </property>
</configuration>


다음은 yarn-site.xml 이다.
<configuration>

<!-- Site specific YARN configuration properties -->
        <property>
                <name>yarn.nodemanager.aux-services</name>
                <value>mapreduce_shuffle</value>
        </property>
        <property>
                <name>yarn.nodemanager.aux-services.mapreduce.shuffle.class</name>
                <value>org.apache.hadoop.mapred.ShuffleHandler</value>
        </property>
        <property>
                <name>yarn.nodemanager.local-dirs</name>
                <value>/appData01/hadoop/yarn/nm-local-dir,/appData02/hadoop/yarn/nm-local-dir,/appData03/hadoop/yarn/nm-local-dir,/appData04/hadoop/yarn/nm-local-dir</value>
        </property>
        <property>
                <name>yarn.resourcemanager.address.rm1</name>
                <value>master1:8032</value>
        </property>
        <property>
                <name>yarn.resourcemanager.webapp.address.rm1</name>
                <value>master1:8088</value>
        </property>
        <property>
                <name>yarn.resourcemanager.scheduler.address.rm1</name>
                <value>master1:8030</value>
        </property>
        <property>
                <name>yarn.resourcemanager.resource-tracker.address.rm1</name>
                <value>master1:8031</value>
        </property>
        <property>
                <name>yarn.resourcemanager.admin.address.rm1</name>
                <value>master1:8041</value>
        </property>

        <property>
                <name>yarn.resourcemanager.address.rm2</name>
                <value>master2:8032</value>
        </property>
        <property>
                <name>yarn.resourcemanager.webapp.address.rm2</name>
                <value>master2:8088</value>
        </property>
        <property>
                <name>yarn.resourcemanager.scheduler.address.rm2</name>
                <value>master2:8030</value>
        </property>
        <property>
                <name>yarn.resourcemanager.resource-tracker.address.rm2</name>
                <value>master2:8031</value>
        </property>
        <property>
                <name>yarn.resourcemanager.admin.address.rm2</name>
                <value>master2:8041</value>
        </property>

        <property>
                <name>yarn.resourcemanager.fs.state-store.uri</name>
                <value>/appData01/hadoop/yarn/system/rmstore,/appData02/hadoop/yarn/system/rmstore,/appData03/hadoop/yarn/system/rmstore,/appData04/hadoop/yarn/system/rmstore</value>
        </property>
        <property>
                <name>yarn.resourcemanager.hostname.rm1</name>
                <value>master1</value>
        </property>
        <property>
                <name>yarn.resourcemanager.hostname.rm2</name>
                <value>master2</value>
        </property>

        <!-- configure yarn -->
        <property>
                <name>yarn.nodemanager.resource.cpu-vcores</name>
                <value>10</value>
        </property>
        <property>
                <name>yarn.nodemanager.resource.memory-mb</name>
                <value>40960</value>
        </property>
        <property>
                <name>yarn.scheduler.minimum-allocation-mb</name>
                <value>1024</value>
        </property>
        <property>
                <name>yarn.scheduler.maximum-allocation-mb</name>
                <value>24576</value>
        </property>

        <!-- ResourceManager 시작시 state 복구여부 --> 
        <property> 
                 <name>yarn.resourcemanager.recovery.enabled</name> 
                 <value>true</value> 
        </property> 
        <!-- persistent store로 사용할 class --> 
        <property> 
                 <name>yarn.resourcemanager.store.class</name> 
                 <value>org.apache.hadoop.yarn.server.resourcemanager.recovery.ZKRMStateStore</value> 
        </property> <!-- Zookeeper 서버 리스트 --> 
        <property> 
                 <name>yarn.resourcemanager.zk-address</name> 
                 <value>master1:2181,master2:2181,master3:2181</value> 
        </property>
        <property>
                <name>yarn.resourcemanager.ha.enabled</name>
                <value>true</value>
        </property>

        <!-- ResourceManager가 leader election에 참가할 cluster 이름 지정 -->
        <property>
                <name>yarn.resourcemanager.cluster-id</name>
                <value>rm-cluster</value>
        </property>
        <!-- cluster에서 HA를 구성할 ResourceManager id 지정 -->
        <property>
                <name>yarn.resourcemanager.ha.rm-ids</name>
                <value>rm1,rm2</value>
        </property>
</configuration>


다음은 mapred-site.xml이다
<configuration>
        <property>
                <name>mapreduce.framework.name</name>
                <value>yarn</value>
        </property>

        <!-- mapreduce2 memory setting -->
        <property>
                <name>yarn.app.mapreduce.am.resource.mb</name>
                <value>1536</value>
        </property>
        <property>
                <name>mapreduce.map.memory.mb</name>
                <value>4096</value>
        </property>
        <property>
                <name>mapreduce.reduce.memory.mb</name>
                <value>8192</value>
        </property>

        <!-- mapreduce java memory setting -->
        <property>
                <name>mapreduce.map.java.opts.max.heap</name>
                <value>3276</value>
        </property>
        <property>
                <name>mapreduce.reduce.java.opts.max.heap</name>
                <value>6553</value>
        </property>

                <property>
                <name>yarn.app.mapreduce.am.resource.mb</name>
                <value>2048</value>
        </property>

                <property>
                                 <name>yarn.app.mapreduce.am.env</name>
                                 <value>HADOOP_MAPRED_HOME=/data01/sw/hadoop</value>
                </property>
                <property>
                                <name>mapreduce.map.env</name>
                            <value>HADOOP_MAPRED_HOME=/data01/sw/hadoop</value>
                </property>
                <property>
                                <name>mapreduce.reduce.env</name>
                                <value>HADOOP_MAPRED_HOME=/data01/sw/hadoop</value>
                </property>

</configuration>


여기까지 하면 하둡 파일은 다 작성이 되었고 이 디렉토리를 마스터2~3, 데이터노드들에 복사를 하자.

scp -r hadoop-3.1.4 ip:/data01/sw/ 


네임노드 HA는 주키퍼로 한 것인데 주키퍼는 가벼우면서도 참으로 편리하다.
zkfc 실행 전 포맷 한번 해주고
hdfs zkfc -formatZK

마스터 1~3번기에서 저널노드 실행
현재 : hdfs --daemon start journalnode 
과거 : hadoop-daemon.sh start journalnode

마스터 1번기에서 네임노드 초기화
hdfs namenode -format

마스터 1번기에서 네임노드 실행
현재 : hdfs --daemon start namenode 
과거 : hadoop-daemon.sh start namenode


마스터 1번기에서 zkfc 실행
현재 : hdfs --daemon start zkfc 
과거 : hadoop-daemon.sh start zkfc

이제 마스터 1번기가 active 상태가 되었다.
이제 마스터 2번기를 standby로 올리자.

마스터 2번기에서 스탠바이상태로 세팅
hdfs namenode -bootstrapStanby

마스터 2번기에서 스탠바이 네임노드 실행
hdfs --daemon start namenode 

마스터 2번기에서 zkfc 실행
hdfs --daemon start zkfc

이제 리소스매니저(yarn)을 올린다.
마스터 1번기에서 yarn --daemon start resourcemanager 실행.

마스터 3번기에서 jobhistory server 실행
현재 : mapred --daemon start historyserver
과거 : sbin/mr-jobhistory-daemon.sh start historyserver

마스터 2번기에서도 yarn을 올린다.
yarn --daemon start resourcemanager

마지막으로 데이터노드들에서 노드매니저를 올린다.
yarn --daemon start nodemanager

그림 작업은 끝이났다.
마스터1:50070 혹은 마스터2:50070에 접근을 해보면 active/standby를 확인할 수 있다.
테스트를 해보기 위해서 active namenode를 kill해보면 아직 사용을 안해서 거의 즉시 failover가 되기는 한다. 이제 배치에서도 네임스페이스를 활용하도록 하자!


네임노드 ha와 리소스매니저 ha가 끝이났다.
하둡이 버전이 올라가면서 가장 크게 바뀐 것은 아무래도 명령어가 바뀌고 workers 파일로 바뀌었다는것, 포트가 바뀌었다는 것, 내부적으로는 압축 효율이 바뀌었다는 점 정도인 것 같다. 그리고 ui가 많이 바뀌었다. 적응이 안된다.

만약에 설치를 하다가 제대로 안되면(특히 포맷) 해당 개인이 사용하려고 생성했던 디렉토리를 삭제하고 다시 해보도록 하자. 그 안에 파일들이 이미 만들어져서 사용되고 있기 때문에 안될 가능성이 높다.

아래 명령어로 네임노드 Active/Standby를 확인 가능하다. 한번만 쳐도 알아낼 수 있는 명령어가 있었으면 좋겠다.
hdfs haadmin -getServiceState namenode1
hdfs haadmin -getServiceState namenode2

리소스매니저 Active/Standby 상태 확인은 다음과 같다.
yarn rmadmin -getServiceState rm1
yarn rmadmin -getServiceState rm2

개인적으로 네임노드2대를 VIP로 사용하여 인터페이스를 해야하는 경우가 아니라면 딱히 VIP는 필요없어보이고 어차피 네임스페이스로 접근하여 해결하도록 하자.

2019년 4월 9일 화요일

하둡 3.1.2 설치 3편 - 독립실행모드(Standalone), 가상분산모드(Pseudo-distributed), 완전분산모드(Fully distributed)

1. 독립실행모드편
-> 하둡 3.1.2 설치 1편 - 독립실행모드(Standalone), 가상분산모드(Pseudo-distributed), 완전분산모드(Fully distributed)

2. 가상분산모드편
-> 하둡 3.1.2 설치 2편 - 독립실행모드(Standalone), 가상분산모드(Pseudo-distributed), 완전분산모드(Fully distributed)

3. 완전분산모드편
-> 하둡 3.1.2 설치 3편 - 독립실행모드(Standalone), 가상분산모드(Pseudo-distributed), 완전분산모드(Fully distributed)

이번편에서는 하둡 시스템 운영용으로 완전분산모드를 설치해본다.
독립실행모드와 가상분산모드의 경우 장비 1대만 있으면 충분했지만 완전분산모드는 실제 장비 여러 대를 클러스터하여 구성할 것이다.

하둡 3.1.2버전으로 설치할 것이며 대부분의 예제가 1.대 버전이어서 조금 힘들었다. 2.대 예제는 별로 없고 3.대는 참고할만한 예제가 정말 없었다.(내가 못찾았을 수도 있지만..)
결론부터 말하자면 계속 데이터노드가 안떠서 고생했는데 이게 제대로 된건지 확실치가 않으니 몇가지 테스트해보고 잘못된 점이 있으면 수정해야겠다.

구성 시나리오는 총 5대로 구성할것이고 마스터노드 2대, 슬레이브노드 3대 이다.
master01 - namenode
master02 - secondarynamenode
slave01 - datanode
slave02 - datanode
slave03 - datanode

실제 운영하려면 한 노드에 마스터+슬레이브를 같이두는 것보다는 물리적으로 분리시키는 것이 좋을 것이기 때문에 이렇게 구성했다.
참고로 세컨더리네임노드는 네임노드의 백업이 아니다. 혹시나해서 네임노드를 죽여도 세컨더리 노드가 Active-StandBy 모드로 살아나지 않는다.

ip주소는 다음처럼 세팅을 하고자한다.
master01 192.168.10.1
slave01 192.168.10.2
slave02 192.168.10.3
slave03 192.168.10.4
master02 192.168.10.5
네트마스크는 255.255.255.0
게이트웨이는 192.168.10.254
네임서버는 192.168.10.254로 설정을 하기로 한다.


먼저 master01부터 적용해보자.

centos7은 ens33으로 되있어서 이를 수정해주었다.
gedit /etc/sysconfig/network-scripts/ifcfg-ens33

파일 내부를 다음과 같이 수정하였다.

그리고 네트워크를 재시작하면 적용이 된다.

같은 작업을 각각의 노드에 모두 적용하고 네트워크를 재시작하였다.
단 각 노드별로 ip만 바꿔주면 된다. (192.168.10.1~5까지 세팅하였다.)

이제 각 host명을 변경한다.

gedit /etc/hosts

모든 노드에 들어가서 다음과 같이 수정한다.

각 호스트이름도 바꿔준다.
gedit /etc/hostname


각각의 노드를 master01, master02, slave01, slave02, slave03으로 바꿔주었다.

그리고 각 노드에 적용을 해준다.

그리고 각각의 노드에서 터미널을 닫았다가 열면 호스트명이 localhost가 아닌 정해준 이름으로 표현이 된다. 이제 5대 모두 reboot해주자.

각 노드에서 각 노드별로 ping을 날려서 연결이 되는지 확인해보자.
master01 -> slave01, slave02, slave03를 해주고
master02 -> slave01, slave02, slave03를 해주고
slave01 -> master01, slave02, slave03를 해주고
...
slave02, 03도 똑같이 3대 노드에 ping 을 날려서 잘 가는지 확인한다.

하둡은 각 노드간에 로그인을 해야 데이터를 주고받을 수 있는데 이때 ssh를 통해 통신을 한다. 따라서 ssh 공개키를 복사한다.

먼저 master01에서 생성한 공개키를 모든 노드에 복사한다.
사실 기존에 가상분산모드에서 만든 노드를 복사해서 사용했기 때문에 공개키까지 복사가 되어서 ssh 연결이 되지만 처음이라고 생각하고 모두 다시설정하기로 한다.

먼저 master01부터 진행하는데 master02~slave03까지 4대에 인증키를 복사해준다.
scp -rp ~/.ssh/authorized_keys root@slave02:~/.ssh/authorized_keys
scp -rp ~/.ssh/authorized_keys root@slave03:~/.ssh/authorized_keys
scp -rp ~/.ssh/authorized_keys root@master02:~/.ssh/authorized_keys

공개키를 복사해주고 master01에서 master02, slave01~slave03까지 ssh 접속이 되는 것을 확인할 수 있다.

각 노드마다 ssh 노드명을 쳐서 접속이 되는지 확인한다.
똑같은 반복작업이지만 잘 되는지 꼭 해주도록 하자.

이제 하둡 파일들을 수정한다.

다음은 hadoop-env.sh를 수정하는데 master만 진행한다.
gedit $HADOOP_HOME/etc/hadoop/hadoop-env.sh

HADOOP_PID_DIR의 경로를 설정해준다.


다음은 core-site.xml을 수정하는데 모든 노드에서 진행한다.
gedit $HADOOP_HOME/etc/hadoop/core-site.xml

다음은 hdfs-site.xml를 모든 노드에서 수정한다.
gedit $HADOOP_HOME/etc/hadoop/hdfs-site.xml

master

slave


다음은 mapred-site.xml을 잡트래커 설정을 수정하며 모든 노드에 mapreduce 설정을 해준다.
gedit $HADOOP_HOME/etc/hadoop/mapred-site.xml


다음은 모든 노드에서 yarn-site.xml을 수정한다.
gedit $HADOOP_HOME/etc/hadoop/yarn-site.xml

<configuration>
    <property>
        <name>yarn.nodemanager.aux-services</name>
        <value>mapreduce_shuffle</value>
    </property>
    <property>
        <name>yarn.resourcemanager.hostname</name>
        <value>master01</value>
    </property>
    <property>
        <name>yarn.nodemanager.resource.memory-mb</name>
        <value>2048</value>
    </property>
    <property>
        <name>yarn.nodemanager.resource.cpu-vcores</name>
        <value>1</value>
    </property>
<property>
        <name>yarn.nodemanager.env-whitelist</name>        <value>JAVA_HOME,HADOOP_COMMON_HOME,HADOOP_HDFS_HOME,HADOOP_CONF_DIR,CLASSPATH_PREPEND_DISTCACHE,HADOOP_YARN_HOME,HADOOP_MAPRED_HOME</value>
    </property>


보통 여기까지 작업하면 masters, slaves 파일을 수정(없으면 생성)하는 것 같은데 그냥 skip하고 workers라는 파일이 있어서 master에서만 workers파일을 수정해주었다.

gedit $HADOOP_HOME/etc/hadoop/workers


아마 workers 파일에 worker들을 알려주면 각각의 노드 start, stop을 안하고 master만 start, stop하면 cluster되어 동작하는 것 같다. (ssh 인증이 반드시 되어있어야 한다.)

이후 마스터노드1번기를 포맷한다.
$HADOOP_HOME/bin/hdfs namenode -format

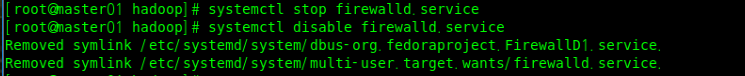
모든 노드의 방화벽을 내려준다.
systemctl stop firewalld.service
systemctl disable firewalld.service


이제 완전분산모드 하둡을 올려볼 것인데 master01에서 각각의 명령어를 날렸다.

start-dfs.sh를 수행한 후 각각 노드 변화


master01에는 NameNode가 올라왔다.


master02에는 SecondaryNameNode가 올라왔다.


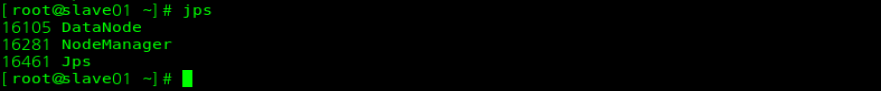
slave01~03에는 DataNode가 올라왔다.


다음으로 start-yarn.sh를 수행하고 각각 노드 변화


master01에는 ResourceManager, NodeManager가 올라왔다.


master02에는 NodeManager가 올라왔다.


slave01~03에는 NodeManager가 올라왔다.

이제 정상적으로 동작하는지 테스트를 해봐야겠다.

하둡 Cluster Setup 가이드를 참고했다. (링크)


20190414 추가

독립, 가상분산모드에서 테스트했던 wordcount를 테스트해본다.
hdfs dfs -mkdir /user
hdfs dfs -mkdir /user/root
hdfs dfs -mkdir /user/root/cont
hdfs dfs -mkdir /input
hdfs dfs -copyFromLocal /home/centos/hadoop-3.1.2/README.txt /input


먼저 하둡 파일시스템에 /user, /user/root, /user/root/conf, /input 디렉토리를 생성하고 /input에 로컬에 있는 README.txt 파일을 올린다.


잘 올라온 것을 확인했다.

이제 샘플을 돌려본다.
hadoop jar $HADOOP_HOME/share/hadoop/mapreduce/hadoop-mapreduce-examples-3.1.2.jar wordcount /input/README.txt ~/wordcount-output

 맵부터 진행하고 리듀스 작업이 진행된다.

결과는 다음과 같다.


2019년 4월 6일 토요일

하둡 3.1.2 설치 2편 - 독립실행모드(Standalone), 가상분산모드(Pseudo-distributed), 완전분산모드(Fully distributed)

1. 독립실행모드편
-> 하둡 3.1.2 설치 1편 - 독립실행모드(Standalone), 가상분산모드(Pseudo-distributed), 완전분산모드(Fully distributed)

2. 가상분산모드편
-> 하둡 3.1.2 설치 2편 - 독립실행모드(Standalone), 가상분산모드(Pseudo-distributed), 완전분산모드(Fully distributed)

3. 완전분산모드편
-> 하둡 3.1.2 설치 3편 - 독립실행모드(Standalone), 가상분산모드(Pseudo-distributed), 완전분산모드(Fully distributed)

저번에는 Hadoop을 Standalone Mode로 설치하였다.
이어서 Pseude-distributed Mode로 설치해보자. 
Single이지만 Cluster이기 때문에 Single Node Cluster라고도 부른다.

가상분산모드는 장비 1대를 가지고 흉내만 내는 것이지만 설치할 때는 분산처리를 할 수 있도록 해야하기 때문에 ssh도 설치해야한다.

저번 편에서 설치한 독립실행모드에 그대로 설치해도되고 아니면 리눅스를 새로 설치하고 jdk와 하둡만 설치해서 따로 설치해도된다. 설치내용은 100% 똑같기때문에 이어서 설치하도록 한다.

먼저 yum install openssh*를 설치한다.

공개키와 비밀키를 생성한다.
ssh-keygen -t rsa -P ""를 수행하여 디폴트로 생성을 한다.


수행하면 아래에 SHA256으로 암호화된 것이 fingerprint(지문)이다.

인증기로 등록한다.

ssh 접속이 되는지 확인을 한다.
최초에만 연결하겠냐고 물어보고 이후에는 물어보지 않는다.

이제 하둡 설정파일을 세팅해야한다.
먼저 hadoop-env.sh에 자바 홈을 알려준다.
vi로 편집하다가 gedit으로 열어서 line number 표시를 하니까 편하다.


3.1.2 버전기준으로 54번째 line에 위치한다.(위치는 버전마다 다르다.)

core-site.xml에 네임노드(마스터노드) 위치를 알려준다.

configuration이 비어있는데 여기에 네임노드 위치를 알려준다.

hdfs-site.xml에 각 파일을 몇 개로 복제할 것인지 설정한다.
기본 3개인줄 알았는데 1개로도 설정이 가능하다.


아래처럼 configuration을 수정해준다.


이제 네임노드를 포맷하고 하둡 클러스터를 시작해보자.
먼저 네임노드를 포맷한다. (hdfs namenode -format)

그리고 하둡 클러스터를 다시 수행해보면 노드들이 하나씩 올라온다.

jps명령어를 수행해보면 jvm위에 올라가있는 프로세스를 확인할 수 있다.

NameNode, SecondaryNameNode, DataNode가 올라와있는 것을 확인할 수 있다.

참고로 start-dfs.sh는 hdfs를 실행하는 명령어이고 끄는 것은 stop-dfs.sh이다.

HDFS만 실행 : start-dfs.sh
HDFS만 중단 : stop-dfs.sh
맵리듀스만 실행 : start-mapred.sh
맵리듀스만 중단 : stop-mapred.sh
HDFS와 맵리듀스 모두 실행 : start-all.sh
HDFS와 맵리듀스 모두 중단 : stop-all.sh


웹상에서 확인하는 방법은 http://localhost:9870에 들어가보면 확인할 수 있다.


2.9대 버전까지는 port가 50070이었으나 3.대 알파버전부터 바뀌었다.(링크)


다음으로 리소스매니저를 수행해본다.

jps로 확인해보면 NodeManger, ResourceManager가 구동된 것을 확인할 수 있다.

웹상에서 보려면 port 8088로 확인할 수 있다.

테스트 겸 독립실행모드에서 수행했던 wordcount를 수행해보자.

먼저 hdfs에 디렉토리를 생성한다.(centos7 로컬이 아니라 하둡에 만드는 것이다.)


localhost:9870에서 /user, /user/root, /user/root/conf, /input을 생성된 것을 확인할 수 있다.


테스트를 위해 로컬에 있는 파일을 hdfs로 올려보자.

localhost:9870에서 README.txt가 올라온 것을 확인할 수 있다.

또는 명령어로도 확인이 가능하다.


독립실행모드에서 수행했던 명령어의 인풋과 아웃풋을 바꿔서 수행해보자.

hadoop jar $HADOOP_HOME/share/hadoop/mapreduce/hadoop-mapreduce-examples-3.1.2.jar wordcount /input/README.txt ~/wordcount-output

hdfs dfs -ls ~/wordcount-output로 _SUCCESS가 된 것을 확인할 수 있다.

아래 명령어를 통해 결과를 확인해보자.

단어의 갯수가 세어진 것을 확인할 수 있다.

또는 localhost:9870에 /root/wordcount-output에서 결과를 확인할 수 있다.


전편 포스팅에서 독립실행모드를 설치하였고 이번 포스팅에서 가상분산모드를 설치하였다.
다음 포스팅에서는 실제 운영할 수 있는 완전분산모드를 설치해보도록 하자.

전편 포스팅(독립실행모드 설치)
-> 하둡 3.1.2 설치 1편 - 독립실행모드(Standalone), 가상분산모드(Pseudo-distributed), 완전분산모드(Fully distributed)

이번 포스팅(가상분산모드 설치)
-> 하둡 3.1.2 설치 2편 - 독립실행모드(Standalone), 가상분산모드(Pseudo-distributed), 완전분산모드(Fully distributed)

다음 포스팅(완전분산모드 설치)
-> 하둡 3.1.2 설치 3편 - 독립실행모드(Standalone), 가상분산모드(Pseudo-distributed), 완전분산모드(Fully distributed)

2022년 회고

 올해는 블로그 포스팅을 열심히 못했다. 개인적으로 지금까지 경험했던 내용들을 리마인드하자는 마인드로 한해를 보낸 것 같다.  대부분의 시간을 MLOps pipeline 구축하고 대부분을 최적화 하는데 시간을 많이 할애했다. 결국에는 MLops도 데이...